AI 智能体正逐渐融入人们的工作方式。要让智能体在 PC 上运行,仅有强大的模型还不够,还需要能够协同工作的硬件与软件。
点击此处阅读 Unsloth 与 AMD NPU 的官方文档:AMD NPU | Unsloth 官方文档
AMD 与 Unsloth 合作,为 Unsloth Desktop 引入了 NPU 支持,使采用 AMD XDNA 2 架构的 NPU 成为全球首款获得该应用支持的 NPU。通过集成 Lemonade 和 FastFlowLM(FLM),双方将 Unsloth 用户生态与专用 NPU 加速能力连接起来。
这为发挥 NPU 的作用带来了一种新方式:通过用户熟悉的应用,在本地高效运行智能体推理。
一颗 AMD NPU 支持 100 多款智能体应用
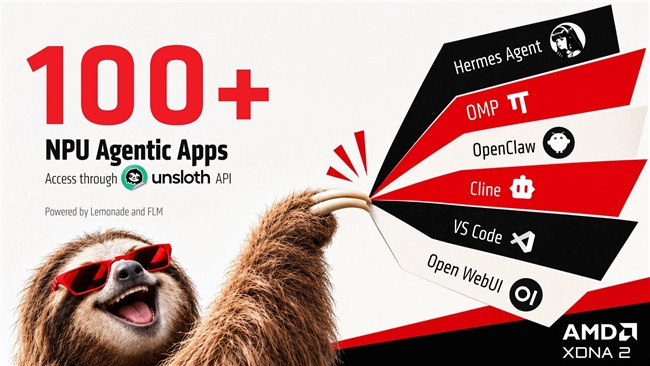
这项合作的影响不止于单一应用。Unsloth Desktop API 为兼容应用提供符合 OpenAI API 规范的端点,通过这一接口,此次集成为 100 多款智能体应用及工作流打开了大门。
Hermes Agent、OpenClaw、Open WebUI、Cline、OMP 和 VS Code 等工具展现了这一生态的广泛覆盖范围,从编程辅助到互联的智能体工作流,均包含在内。应用通过 Unsloth Desktop API 调用本地模型推理,而 Lemonade 和 FLM 则负责面向 AMD XDNA 2 NPU 的模型服务与推理执行。
AMD 与 Unsloth 携手拓展了开发者部署智能体工作负载的选择,也丰富了用户体验本地 AI 的方式。
让智能体不再受接电束缚
随着智能体承担更多工作,高能效运行变得越来越重要。
AMD XDNA 2 NPU 专为高能效 AI 推理而设计。将受支持的推理工作负载卸载至这一专用引擎,有助于延长电池续航,并为其他应用保留 CPU 和 GPU 资源(前提是内存充足)。
对用户而言,这为更契合日常 PC 使用方式的智能体体验奠定了基础,即使不接电源,也能更充分地利用电池续航。对开发者而言,这为将本地 AI 融入日常工作流提供了另一种执行选择,让低功耗、持续运行的智能体成为可能。
如何在 AMD XDNA 2 NPU 上运行 Unsloth Desktop
1. 在配备 XDNA 2 NPU 的 AMD 设备上,下载并安装 Windows 版 Unsloth Desktop(下载链接:https://www.amd.com/en/blogs/2026/unlocking-the-amd-ryzen-ai-npu-for-unsloth-desktop.html)。
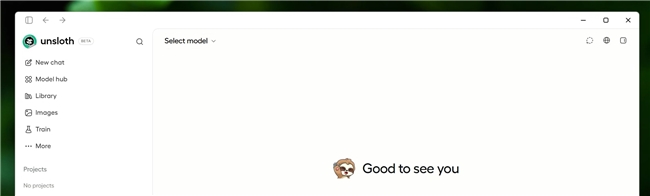
2. 进入模型中心(Model Hub)页面,点击筛选图标,然后从下拉列表中选择 NPU。
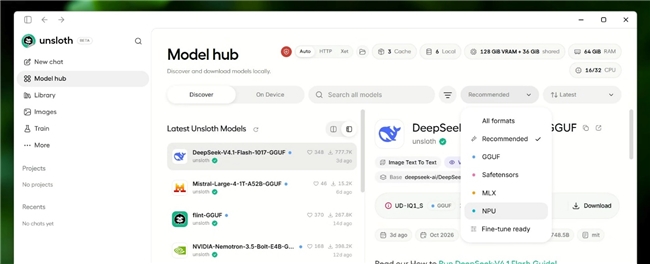
3. 点击“Enable NPU”(启用 NPU)。
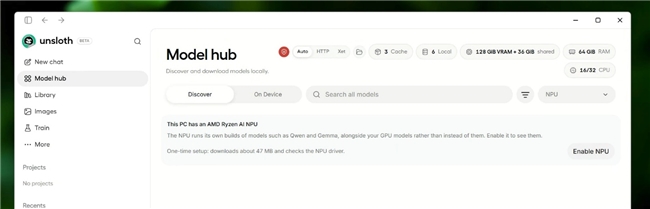
4. 下载您希望运行的 NPU 模型。注意:不同模型的内存需求各不相同。例如,Qwen 3.6 35B A3B 模型在使用完整上下文长度时,需要约 28 GB 可供 NPU 使用的内存。按照 Windows 默认 50% 的共享内存分配比例,系统需要配备 64 GB 内存。

5. 等待下载完成(即使看起来像是卡住了,下载实际上仍在进行)。然后返回“New Chat”(新建聊天),在下拉菜单中向下滚动,找到“NPU”分区,按所需的上下文长度加载模型,即可开始在 NPU 上进行推理!
通过在硬件、推理软件和应用生态层面协同推进,AMD 与 Unsloth 正让 NPU 加速惠及更多开发者和用户。
更多应用,更高效的本地推理,为 PC 上的智能体 AI 开启全新可能。
免责声明:本站转载的文章,版权归原作者所有;旨在传递信息,不代表本站的观点和立场。